在制作电子病历全文索引时,需要建立索引,索引是根据索引词建立的,现有索引词匮乏,不能满足需求,搜寻之后,发现搜狗输入法的医学词库很庞大,所以,想着自学写一个Python脚本,完成词库的自动下载工作正文分析参考资料代码
通过分析代码发现,思路是:获取分类链接获取该分类的分页链接获取该页下载链接-->生成一个list通过list下载内容所需模块知识补充1、requests和BeautifulSoup模块(分类、分页、下载链接都涉及)
爬取网页过程获取网页数据-->requests模块,并转换成txt格式解析数据-->BeautifulSoup模块,txt转换成bs对象提取相关数据-->需要分析url找到想要的数据内容,确定对应的class_
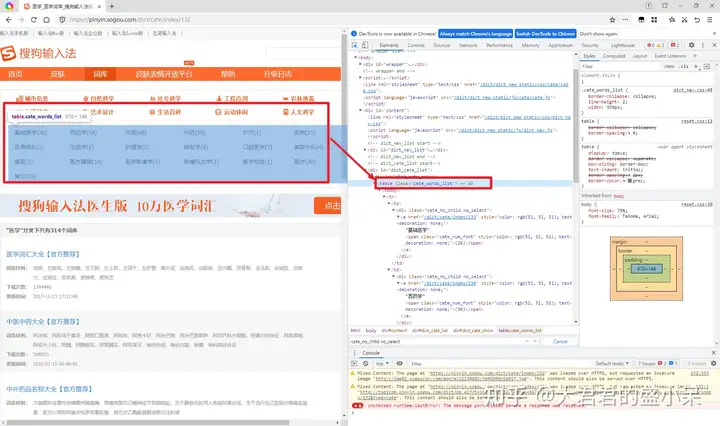
举例,小分类的全部链接可以在cate_words_list的table下面全部找到,所以提取整体内容items = soup.find_all(table, class_=cate_words_list)
2、write模块def download_dict(dl_url, path): res = requests.get(dl_url, timeout=5) with open(path, "wb") as fw: fw.write(res.content)
总结解析网页和下载内容部分进行了详细解释,针对如何将scel文件转换成txt文件,这里先不做讲解了(我也没弄明白呢),下次有机会再给大家分析分析附赠代码下载链接我用夸克网盘分享了「搜狗词库的批量下载#Python」,点击链接即可保存。
打开「夸克APP」,无需下载在线播放视频,畅享原画5倍速,支持电视投屏链接:https://pan.quark.cn/s/2d42c4b3ee60提取码:dtp5参考资料Python 搜狗词库的批量下载
| 欢迎光临 怎通站长论坛 (http://cloud.dachanpin.com/) |